Qwen3.5-4B, 작게 저장하면 무엇이 달라질까?
전체 모델 양자화 실험 · 2026.09.22 · 측정·검토 완료
우리가 배운 양자화를 모델 전체에 적용했다. 관심사는 하나다. 가중치를 적은 비트로 저장하면서, 원래 하던 계산과 답변을 얼마나 유지할 수 있을까?
아래에서 ‘원본’은 양자화 전 모델, ‘복원 가중치’는 압축된 값으로 실제 계산에 사용하는 근삿값을 뜻한다. 각 설정은 첫 비교를 위해 고정했으며, 모든 방법의 최적값을 탐색한 결과는 아니다.
BF16은 원본이 주로 사용하는 16비트 수치 표현이다. llama.cpp와 vLLM은 모델을 실행하는 프로그램이며, GGUF와 HF는 이 보고서에서 비교하는 모델 파일 계열이다.
| 궁금한 점 | 이번에 확인한 결과 | 함께 읽을 조건 |
|---|---|---|
| 원래 예측을 가장 잘 유지했나? | GGUF 후보에서는 Q4_K_M | 모든 문제의 정답률까지 가장 높지는 않았다. |
| 작게 저장하고 빠르게 생성했나? | GGUF 후보에서는 IQ4_XS | 이 장비·입력 길이·실행 설정에서의 결과다. |
| 같은 INT4 공간을 더 잘 썼나? | GPTQ가 RTN·이번 AWQ보다 문서 예측 오차가 작았다. | 같은 비트 수·그룹 크기·대상 행렬끼리 비교했다. |
읽는 순서: 저장 방식 → 실제 설정 → 예측 품질 → 문제 풀이 → 용량 → 속도 → 결과의 신뢰 범위. 수식 아래에서 기호를 바로 설명하고, 측정값은 표에 모았다.
1. 무엇을 압축했나
기본 원리는 ‘가중치를 제한된 값 중 하나로 옮기고, 공통 스케일로 복원한다’는 것이다. 아래는 그룹 양자화의 일반적인 표현이다.
| 기호 | 읽는 법 | 실제 역할 |
|---|---|---|
| w → \hat w | 원본 → 복원 가중치 | 두 값 사이에 근사 오차가 생긴다. |
| q | 저장할 저비트 값 | 4비트라면 16개 코드 중 하나를 저장한다. |
| d | 그룹 복원 스케일 | 표현 가능한 값들의 간격을 정한다. |
| z | 영점 위치 | 실수 0에 대응하는 정수 위치다. 대칭 방식에서는 별도의 자유로운 영점을 탐색하지 않는다. |
| round / clip | 반올림 / 범위 제한 | 가까운 값으로 옮기고, 표현 범위 밖이면 경계에서 제한한다. |
이 식은 출발점이다. Q4_K는 작은 블록의 스케일·오프셋을 슈퍼블록 안에서 다시 압축하고, IQ4_XS는 간격이 일정하지 않은 대표값 표를 사용한다.
우리 FFN 행렬 하나를 예로 들면 다음과 같다.
그룹 128은 각 행의 가중치를 입력 방향으로 연속된 128개씩 묶는다는 뜻이다. 한 행에는 72개 그룹이 생긴다. 그룹 안의 가중치들은 각자 다른 4비트 값을 가지며, 복원 스케일만 공유한다.
| 이번 모델에서의 처리 | 범위 | 이유·의미 |
|---|---|---|
| 저비트로 바꾼 큰 행렬 | 200개, 가중치 약 35.65억 개 | FFN, 일반 어텐션, 선형 어텐션의 큰 선형 변환을 공통 대상으로 고정했다. |
| 고정밀로 보존한 부분 | 임베딩·공유 출력 가중치, 정규화, 작은 상태 관련 가중치 등 | 전체 모델 실행을 비교하되 모든 가중치를 4비트로 만든 것은 아니다. |
| 이번 평가 범위 | 텍스트 입력·출력 | 시각 모듈과 MTP의 품질은 평가하지 않았다. |
2. 방식마다 무엇을 다르게 정했나
저장 규격은 ‘어떤 값을 몇 비트로 담을지’를 정한다. 양자화 알고리즘은 ‘그 공간에 어떤 값을 넣어야 손실이 적을지’를 정한다. 이번 두 계열은 저장 규격도 달라서, 계열 사이의 점수 차이를 알고리즘 하나의 효과로 해석하지 않는다.
| 후보 | 저장 구조 | 오차를 줄이는 방법 |
|---|---|---|
| Q4_K · 중요도 미사용 | 32개 소블록 × 8 = 256개 슈퍼블록 | 가중치와 내장 근사 절차로 스케일·오프셋을 맞춘다. 단순 반올림만 하는 기준선은 아니다. |
| Q4_K · 중요도 사용 | 위와 동일 | 실제 입력에서 얻은 중요도(imatrix)를 근사에 반영한다. |
| Q4_K_M · 중요도 사용 | Q4_K 168개 + Q6_K 32개 행렬 | 일부 행렬을 더 정밀하게 저장한다. 배정은 llama.cpp의 내장 정책이다. |
| IQ4_XS · 중요도 사용 | 비균일한 16개 대표값 + 블록 스케일 | 균등 간격과 다른 표현 방식으로 같은 비트 수를 활용한다. |
| RTN | 대칭 INT4 · 그룹 128 | 그룹 범위를 잡고 가까운 값으로 반올림한다. |
| GPTQ | RTN과 동일한 저장 조건 | 한 열을 양자화한 뒤 남은 가중치를 보정한다. |
| AWQ | RTN과 동일한 저장 조건 | 입력 채널별 배율을 조정한 다음 양자화한다. |
우리가 고정한 것은 탐색 조건이고, 각 그룹의 스케일 값 자체는 도구가 계산했다. 모델 전체에 같은 스케일 하나를 넣은 것이 아니다. 아래 값들은 이번 실행 설정이며 최적값이라는 뜻은 아니다.
| 설정 | 이번 값 | 왜 이렇게 시작했나 / 무엇이 달라지나 |
|---|---|---|
| RTN·GPTQ·AWQ 그룹 크기 | 128 | 같은 저장 조건의 기준 비교. 작게 하면 범위를 세밀하게 맞추기 쉬워지는 대신 스케일 개수가 늘어난다. |
| 가중치 / 입력 계산 정밀도 | 4비트 / BF16 | 가중치 압축 효과를 비교하며 입력값까지 저비트로 바꾸지는 않았다. |
| RTN 계열 범위 계산 | minmax · 대칭 | 그룹의 최소·최대에 기반한다. 별도 클리핑 비율 탐색은 하지 않았다. |
| GPTQ 안정화 계수 | 0.01 | 입력 관계 행렬을 이용하는 계산이 지나치게 민감해지는 것을 줄이는 출발값. 계수별 탐색은 하지 않았다. |
| GPTQ 처리 순서 / 계산 블록 | 재배열 끔 / 128열 | 원래 순서로 처리. 계산 블록은 저장 그룹과 다른 개념이며 이후 블록으로 보정이 전달된다. |
| AWQ 배율 탐색 | 지수 20개 · 0~1 | 입력 통계로 만든 배율 후보를 교정 입력의 출력 오차로 비교했다. |
| AWQ 추가 설정 | 입력 통계만 사용 · 별도 클리핑 탐색 없음 | 이번 레시피의 범위다. 다른 AWQ 설정까지 대표하지 않는다. |
| 교정 자료 | 128개 × 1,024토큰 | 중요도·채널 관계·배율을 정할 때 관찰할 입력. 필요한 방법에 같은 창과 순서를 사용했다. RTN은 교정 입력을 사용하지 않는다. |
가중치 자체보다 그 가중치로 계산한 출력을 보존하는 것이 중요하다. 같은 가중치 오차라도 큰 입력과 곱해지면 출력에 더 크게 반영되기 때문이다.
GPTQ는 교정 입력으로 만든 관계 행렬 H를 사용한다. 이번 안정화는 대각에 아래 값을 더하는 방식이다. 가중치를 1% 줄인다는 뜻은 아니다.
AWQ는 채널별 배율 s_j를 곱한 가중치와, 그 역수를 적용한 입력을 짝지어 원래 연산을 유지한다. 이후 양자화에서 생기는 오차를 줄이려는 것이다.
이번 배율 후보는 s_j\propto (\operatorname{mean}|x_j|)^\alpha, \alpha=k/19 (k=0,\ldots,19) 형태였다. 채널 배율 s_j와 저장값을 복원하는 그룹 스케일 d는 서로 다르다. 배율은 2의 거듭제곱으로 제한되지 않는다.
3. 실제 다음 토큰을 얼마나 잘 예측했나
모든 모델에 같은 문서 앞부분을 주고, 실제로 이어지는 다음 토큰에 얼마의 확률을 주는지 확인했다. 여기서 토큰은 모델이 읽는 글 조각이다. 자유롭게 생성한 답변끼리 비교하는 단계와 구분한다.
NLL은 실제 다음 토큰에 낮은 확률을 줄수록 커지는 평균 벌점이다. T는 평가한 토큰 수, p는 모델이 실제 다음 토큰에 준 확률이다. 자연로그를 사용하며 낮을수록 좋다.
| 실제 다음 토큰에 준 확률 | 그 위치의 벌점 −ln(p) | 의미 |
|---|---|---|
| 80% | 0.223 | 실제 다음 토큰을 유력하게 예상했다. |
| 40% | 0.916 | 예상이 덜 확실했다. |
| 10% | 2.303 | 실제 다음 토큰을 가능성이 낮다고 봤다. |
아래 표의 원본 대비 증가량은 양자화 후 늘어난 벌점이다. 같은 엔진의 원본과 비교한다. 오른쪽 ‘확률 비율’은 그 차이를 조금 더 직관적으로 바꾼 값이다.
R은 실제 다음 토큰에 부여한 확률의 양자화/원본 비율을 기하평균한 값이다. 예를 들어 약 98%라면 이 확률 비율이 평균적으로 그 정도라는 뜻이다. 문제 정답률 98%라는 뜻은 아니다.
llama.cpp · GGUF 실행
| 모델 | 예측 벌점 NLL ↓ | 원본 대비 증가 ↓ | 실제 토큰 확률 비율 ↑ |
|---|---|---|---|
| 원본 BF16 | 1.8515 | +0.0000 | 100.00% |
| Q4_K · 중요도 미사용 | 1.8861 | +0.0346 | 96.60% |
| Q4_K · 중요도 사용 | 1.8745 | +0.0230 | 97.73% |
| Q4_K_M · 중요도 사용 | 1.8699 | +0.0184 | 98.18% |
| IQ4_XS · 중요도 사용 | 1.8817 | +0.0302 | 97.02% |
같은 Q4_K에서 중요도를 반영하니 예측 손실이 줄었다. 일부 행렬을 고비트로 저장한 Q4_K_M은 이 GGUF 후보 중 손실이 가장 작았다. IQ4_XS는 더 작은 파일을 만드는 대신 Q4_K_M보다 예측 손실이 컸다.
vLLM · 동일한 INT4 저장 조건
| 모델 | 예측 벌점 NLL ↓ | 원본 대비 증가 ↓ | 실제 토큰 확률 비율 ↑ |
|---|---|---|---|
| 원본 BF16 | 1.8518 | +0.0000 | 100.00% |
| RTN | 1.9407 | +0.0888 | 91.50% |
| GPTQ | 1.8884 | +0.0365 | 96.41% |
| AWQ | 1.9338 | +0.0819 | 92.13% |
같은 저장 공간에서는 GPTQ가 문서 예측을 가장 잘 유지했다. 이번 AWQ도 RTN보다 평균 손실이 작았지만 개선 폭은 더 작았다. 영역별로 보면 영어 문서에서는 AWQ가 RTN보다 조금 나빴다.
| 보고서의 다른 수치 | 무엇을 나타내나 | 어떻게 읽나 |
|---|---|---|
| PPL = exp(NLL) | NLL을 지수로 바꾼 값 | 낮을수록 좋고, 같은 자료에서는 NLL과 순위가 같다. 본문에서는 중복을 줄여 NLL 위주로 읽는다. |
| KL | 원본과 양자화 모델의 전체 다음 토큰 확률 분포 차이 | 원본 보존 정도를 보며 낮을수록 가깝다. 원본의 정답 여부를 평가하는 지표는 아니다. |
| 95% 신뢰구간 | 평가 문서를 다시 뽑을 때 차이가 얼마나 흔들리는지 추정 | 모든 새 사용 상황의 95%를 보장하는 범위가 아니다. 상세 값은 검증 기록에 있다. |
평가는 최종 문서 128개 · 예측 토큰 130,944개에 기반한다. KL은 정해 둔 일부 위치에서만 측정했으며 vLLM에서는 미측정이다. HF의 복원 실행에서 구한 KL을 vLLM 실측으로 표시하지 않았다.
4. 예측 손실이 작으면 문제도 더 잘 풀까
반드시 그렇지는 않았다. NLL은 확률을 연속적인 수치로 평가하지만, 문제 채점은 최종 선택이나 조건 충족 여부를 판단한다.
| 설명용 예시 | 정답 A의 확률 | 오답 B의 확률 | 선택 결과 |
|---|---|---|---|
| 원본 | 51% | 49% | 정답 A |
| 양자화 | 49% | 51% | 오답 B |
확률 변화는 작아도 순위가 뒤집히면 한 문제를 틀린다. 반대로 확률이 달라져도 정답이 계속 1등이면 정답률은 그대로다. 위 값은 원리를 설명하는 예시이며 실측 문항이 아니다.
| 시험 | 무엇을 확인했나 | 표본·읽는 법 |
|---|---|---|
| 한국어 지식 · KMMLU | 여러 분야의 객관식 지식 문제 | 500문항. 과목별 표본이므로 공식 전체 점수와 다르다. |
| 영어 추론 · ARC-C | 영어 과학·추론 객관식 문제 | 500문항. 선택지 길이를 정규화한 점수를 사용했다. |
| 지시 준수 · IFEval | 형식·단어 횟수·길이 등의 요구 | 541문항. 한 요청의 모든 검사 조건을 만족해야 통과한다. |
llama.cpp · 점수는 모두 높을수록 좋음
| 모델 | 한국어 지식 ↑ | 영어 추론 ↑ | 지시 준수 ↑ |
|---|---|---|---|
| 원본 BF16 | 48.2% | 56.2% | 82.62% |
| Q4_K · 중요도 미사용 | 49.4% | 53.0% | 80.41% |
| Q4_K · 중요도 사용 | 46.6% | 54.4% | 80.96% |
| Q4_K_M · 중요도 사용 | 48.8% | 53.8% | 79.85% |
| IQ4_XS · 중요도 사용 | 47.8% | 55.4% | 81.89% |
Q4_K_M의 낮은 문서 손실이 모든 과제의 1위로 이어지지는 않았다. IQ4_XS는 이 표본에서 GGUF 양자화 후보 중 영어 추론·지시 준수 점수가 가장 높았다. 작은 점수 차이로 보편적인 우승 모델을 정하지 않는다.
vLLM · 같은 문제와 채점 조건
| 모델 | 한국어 지식 ↑ | 영어 추론 ↑ | 지시 준수 ↑ |
|---|---|---|---|
| 원본 BF16 | 48.8% | 55.8% | 83.18% |
| RTN | 47.2% | 54.8% | 76.52% |
| GPTQ | 43.2% | 54.8% | 79.67% |
| AWQ | 43.8% | 53.2% | 78.19% |
GPTQ는 RTN보다 지시 준수 점수가 높았지만 한국어 지식 점수는 낮았다. 문서 예측 보존과 문제 풀이 결과를 각각 확인해야 한다. GPTQ와 RTN의 한국어 점수 차이는 신뢰구간이 0을 포함하므로 이 표본만으로 일반적인 우열을 확정하지 않는다.
| 실제 확인한 사례 | 원본 BF16 | 양자화 모델 | 보이는 변화 |
|---|---|---|---|
| 전체 답변을 JSON으로 작성 | 형식 통과 | IQ4_XS: 마지막 바깥 } 누락 |
자연스러운 문장이어도 형식 검사에서 실패한다. |
| peace를 10회 이상 사용 | 11회 · 통과 | 중요도 없는 Q4_K: 9회 · 실패 | 필수 조건을 한 번 덜 지킨 차이가 점수를 바꾼다. |
| 여행 글을 300단어 미만으로 작성 | 307단어 · 실패 | GPTQ: 247단어 · 통과 | 양자화 후 조건을 만족한 경우도 있다. |
이 사례들은 실패·개선 양상을 보여 주는 예시다. 답변의 모든 사실성을 검증하거나, 양자화가 글쓰기 능력을 높였음을 입증한 사례는 아니다. 길이 제한에 걸린 출력도 평가에서 버리지 않았다.
5. 실제 저장 공간은 얼마나 줄었나
전체 파일은 ‘4비트 가중치’만으로 구성되지 않는다.
아래 표는 GB = 10억 바이트를 쓴다. 탐색기에 표시되는 이진 단위 GiB와 숫자가 다를 수 있다. ‘텍스트 데이터’는 파일에서 공통 텍스트 모델의 텐서 데이터만 합친 크기다.
| 모델 파일 | 가중치 파일 GB ↓ | 공통 텍스트 데이터 GB ↓ |
|---|---|---|
| GGUF · 원본 BF16 | 8.424 | 8.413 |
| GGUF · Q4_K · 중요도 미사용 | 3.299 | 3.289 |
| GGUF · Q4_K · 중요도 사용 | 3.299 | 3.289 |
| GGUF · Q4_K_M · 중요도 사용 | 3.464 | 3.453 |
| GGUF · IQ4_XS · 중요도 사용 | 3.188 | 3.177 |
| HF · 원본 BF16 | 9.320 | 8.412 |
| HF · RTN | 3.787 | 3.119 |
| HF · GPTQ | 3.787 | 3.119 |
| HF · AWQ | 3.787 | 3.119 |
GGUF는 텍스트용이고 HF 파일에는 시각 모듈도 포함되므로 파일 전체 크기만으로 두 계열의 압축 효율을 비교하면 안 된다. 설정·토크나이저까지 포함한 폴더 전체 크기는 상세 기록에 따로 있다.
| 비교 | 용량에서 읽을 점 |
|---|---|
| Q4_K 중요도 미사용 ↔ 사용 | 가중치 데이터 크기는 같다. 파일의 320바이트 차이는 메타데이터다. 중요도 계산 자체를 거대한 추가 가중치로 저장하지 않는다. |
| Q4_K → Q4_K_M | 일부 행렬을 6비트로 저장해 약 0.165 GB 늘었다. |
| RTN ↔ GPTQ ↔ AWQ | 같은 저장 조건이라 가중치 파일 크기도 같다. 정교한 계산으로 그 공간에 담는 값을 다르게 정했다. |
6. 작게 저장하면 실제로도 빨라졌나
속도는 두 순간으로 나누어 읽는다. 첫 토큰까지 기다리는 시간과 그 뒤 토큰이 이어지는 속도다.
| 지표 | 쉬운 뜻 | 좋은 방향 |
|---|---|---|
| 첫 토큰 지연 · TTFT | 입력을 받은 뒤 첫 글 조각이 나오기까지 | 짧을수록 좋음 ↓ |
| 입력 처리 · prefill | 입력 문맥을 읽는 처리량 | 높을수록 좋음 ↑ |
| 생성 · decode | 이후 토큰이 이어지는 속도 | 높을수록 좋음 ↑ |
본문은 입력 4,096토큰 · 생성 256토큰 · 요청 1개씩 조건을 비교한다. 각 구성에서 준비 실행 2회 후 5회 측정했고 중앙값을 표시했다. 관측 범위는 5회 중 최솟값~최댓값이며 신뢰구간이 아니다.
llama.cpp · 압축 후 생성 속도가 빨라짐
| 모델 | 첫 토큰 지연 ms ↓ | 생성 토큰/초 ↑ | 생성 속도 관측 범위 |
|---|---|---|---|
| 원본 BF16 | 303.7 | 155.7 | 153.6 ~ 162.5 |
| Q4_K · 중요도 미사용 | 262.2 | 279.3 | 259.8 ~ 285.5 |
| Q4_K · 중요도 사용 | 262.9 | 280.1 | 261.7 ~ 285.8 |
| Q4_K_M · 중요도 사용 | 270.6 | 275.8 | 253.6 ~ 278.3 |
| IQ4_XS · 중요도 사용 | 254.3 | 295.3 | 270.0 ~ 296.4 |
이 실행에서는 IQ4_XS가 가장 작은 GGUF 파일이면서 생성 속도 중앙값도 가장 높았다. Q4_K_M은 더 정밀한 일부 가중치를 유지하며, IQ4_XS보다 파일이 크고 생성은 조금 느렸다.
vLLM · 이번 설정에서는 압축 후 더 빨라지지 않음
| 모델 | 첫 토큰 지연 ms ↓ | 생성 토큰/초 ↑ | 생성 속도 관측 범위 |
|---|---|---|---|
| 원본 BF16 | 201.7 | 56.3 | 45.2 ~ 58.7 |
| RTN | 192.3 | 45.4 | 35.8 ~ 54.3 |
| GPTQ | 217.8 | 50.2 | 36.2 ~ 58.5 |
| AWQ | 211.1 | 45.0 | 41.6 ~ 54.6 |
vLLM은 CUDA graph를 끈 eager 실행에서 측정했다. 저비트 저장만으로 전체 실행이 빨라지는 것은 아니다. 압축값을 읽고 계산하는 구현과 모델의 다른 연산도 영향을 준다. 지연 원인을 따로 분해하지 않았으므로 특정 요소 하나를 원인으로 확정하지 않는다. 반복 간 변동도 커서 작은 속도 차이는 강조하지 않는다.
| 메모리 관측 | 원본 BF16 | INT4 | 해석 |
|---|---|---|---|
| vLLM 시작 로그의 가중치 점유 | 약 7.99 GiB | 약 3.11 GiB | 가중치 자체의 메모리는 줄었다. |
| vLLM 실행 중 GPU 장치 전체 | 약 28~29 GiB | 약 28~29 GiB | 예약 캐시와 다른 앱을 포함한다. 양자화 가중치가 이 크기라는 뜻은 아니다. |
두 엔진의 지연 측정 경계가 완전히 같지는 않다. 위 수치를 HTTP 채팅 서비스 전체 지연이나 엔진 자체의 보편적 우열로 해석하지 않는다. 짧은 입력 결과·prefill·VRAM 상세 수치는 검증 기록에 있다.
7. 어디까지 믿고, 무엇을 더 확인해야 하나
평균이 좋아도 일부 문서에서 더 크게 흔들릴 수 있다. 아래는 문서별 ‘원본 대비 NLL 증가’를 작은 순서로 놓고 본 결과다. p95는 약 95%의 문서가 그 값 이하에 놓이는 경계이며, 실패율 5%를 뜻하지 않는다.
| 모델 | 평균 증가 ↓ | p95 ↓ | 가장 큰 증가 ↓ |
|---|---|---|---|
| llama.cpp · Q4_K · 중요도 미사용 | 0.0346 | 0.0636 | 0.0802 |
| llama.cpp · Q4_K · 중요도 사용 | 0.0230 | 0.0475 | 0.0665 |
| llama.cpp · Q4_K_M · 중요도 사용 | 0.0184 | 0.0395 | 0.0611 |
| llama.cpp · IQ4_XS · 중요도 사용 | 0.0302 | 0.0572 | 0.0738 |
| vLLM · RTN | 0.0888 | 0.1486 | 0.1983 |
| vLLM · GPTQ | 0.0365 | 0.0627 | 0.1367 |
| vLLM · AWQ | 0.0819 | 0.1345 | 0.1809 |
여기서 꼬리가 크다는 것은 일부 문서의 예측 손실이 더 커졌다는 뜻이다. 특정 가중치 하나의 이상치나 실제 채팅의 실패 확률로 바로 바꿔 읽을 수는 없다.
| 공정성·신뢰도 점검 | 이번에 적용한 기준 |
|---|---|
| 설정을 고를 자료와 평가 자료 분리 | 교정 128문서 / 검증 32문서 / 최종 128문서. 문서 해시 중복을 제거했다. |
| 입력과 원본을 고정 | 원본 모델·데이터 버전·문항·토큰·대상 가중치 정책을 기록했다. |
| 실제로 저장한 모델 평가 | 압축 파일을 다시 불러와 실행했다. 복원 실행의 품질 측정과 압축 실행의 속도 측정을 구분했다. |
| 불리한 결과도 포함 | 예정 문항을 분모에 유지하고, 길이 제한 출력도 반환된 답변으로 채점했다. |
| 최종 시험으로 재튜닝하지 않음 | 결과를 본 뒤 설정을 바꿔 같은 최종 시험에 맞추지 않았다. |
| 실행·채점 점검 | 평가 요청 43,066개에서 기술적 실패 0개, 지시 준수 채점 예외 0개. 문제를 모두 맞혔다는 뜻은 아니다. |
| 통계의 범위 | 문서·문항을 짝지어 2,000회 재표집. 양자화 재실행 2,000회가 아니며 여러 후보의 다중 비교 보정은 하지 않았다. |
| 아직 확인하지 않은 것 | 현재 결과를 읽을 때의 경계 |
|---|---|
| 모든 설정의 최적 조합 | 그룹 크기·GPTQ 계수·AWQ 클리핑 등을 폭넓게 탐색하지 않았다. |
| 교정 자료를 바꾼 재양자화 반복 | 고정된 한 교정 구성으로 만든 모델의 결과다. |
| 긴 문맥·실제 사용자 대화·시각 입력 | 이번 텍스트 시험 결과로 전체 사용 상황을 대표하지 않는다. |
| 튜닝된 서버의 최대 성능 | 다중 사용자 처리량·CUDA graph 최적화·최소 메모리 설정은 별도 미측정이다. |
| 데이터 오염의 완전한 부재 | 해시 중복은 제거했지만 의미상 중복이나 원본 모델의 사전학습 노출까지 배제하지 못했다. |
실험 중 재부팅은 저장 결과와 모델 해시를 검증한 뒤 복구했다. 마지막 검토에서 발견한 vLLM 시간 측정 누락은 성능 단계만 같은 조건으로 재측정해 보완했다. 원인 미확정 사항과 수정 전 기록도 보존했다. 상세 경위는 아래 기술 기록에서 확인할 수 있다.
양자화 모델 다운로드
가중치는 Hugging Face에, 코드·보고서·평가 자료는 GitHub에 공개했다. 아래 파일은 보고서에서 평가한 결과물과 해시가 같다.
| 후보 | 저장 형식 | 가중치 파일 GB | HF 소개·사용법 | 파일 받기 |
|---|---|---|---|---|
| K0 · Q4_K · 중요도 미사용 | GGUF | 3.299 | 모델 카드 | 다운로드 |
| K1 · Q4_K · 중요도 사용 | GGUF | 3.299 | 모델 카드 | 다운로드 |
| KM · Q4_K_M | GGUF | 3.464 | 모델 카드 | 다운로드 |
| I4 · IQ4_XS | GGUF | 3.188 | 모델 카드 | 다운로드 |
| R0 · RTN | compressed-tensors INT4 | 3.787 | 모델 카드 | 다운로드 |
| G0 · GPTQ | compressed-tensors INT4 | 3.787 | 모델 카드 | 다운로드 |
| A0 · AWQ | compressed-tensors INT4 | 3.787 | 모델 카드 | 다운로드 |
GB는 10억 바이트이며 가중치 파일만 센 값이다. HF 3종에는 시각 가중치가 포함되고 GGUF는 텍스트 전용이므로 파일 크기만으로 압축 효율을 단정하지 않는다. HF 모델을 실행할 때는 가중치 파일 하나가 아니라 설정·토크나이저를 포함한 저장소 전체를 받는다.
더 살펴볼 자료
| 자료 | 들어 있는 내용 |
|---|---|
| 전체 측정·검증 기록 | 모든 PPL·KL·신뢰구간, 영역별 점수, 내부 블록 오차, 짧은 입력 속도, 사고·복구 기록 |
| 기계 판독용 결과 | 반올림 전 수치, 표본별 차이, 크기, 반복 측정 결과 |
| 실패·개선 응답 | 조건을 놓치거나 새로 통과한 실제 출력 |
| 실행 명세 · 변경 기록 | 고정한 조건, 실행 순서, 수정 이유 |
| AWQ·GPTQ 수학 설명 | 입력 채널·행렬·오차 보상·배율의 전개 |
| llama.cpp 양자화 수학 설명 | 그룹·슈퍼블록·중요도·IQ 계열의 차이 |
이 문서는 동일한 실측 자료를 읽기 쉽게 재구성한 판이다. 새 양자화·재학습·품질 평가를 수행한 판은 아니다. 원본 기술 보고서는 로컬에 보존했고, 공개본은 컴퓨터 경로를 일반화했다. 수치와 판정은 유지했다.
전체 측정·검증 기록 펼치기
편집 전 검토 완료 보고서의 공개용 사본입니다. 상세 수치와 불확실성, 운영상 한계는 유지하고 컴퓨터 경로만 일반화했습니다.
Qwen3.5-4B 전체 모델 양자화 비교
상태: 실측과 최종 검토 완료 (2026-09-22). 아래 수치는 실제 저장 모델의 실행 결과다. 실패·누락은 별도 기록한다.
먼저 읽을 결과
전체 모델 양자화, 저장 파일 재로딩, 품질 평가, 전용 속도·메모리 측정과 최종 검토를 완료했다. 원본/양자화 모델을 포함한 8개 후보를 13개 엔진·후보 조합으로 수치 평가했고, 실제 packed 실행 9개 조합에는 같은 1,541개 과제 문항과 성능 요청을 적용했다. 본 평가 요청 43,066개에 기술적 실행 실패가 없었고, IFEval 9×541개 응답의 채점 예외도 0개였다. 성능은 9개 조합 × 입력 길이 2종 × (warmup 2회 + 측정 5회), 총 126회 중 90회를 요약했다. 43,066개는 서로 다른 시험 문제 수가 아니라 선택지별 호출·문서·여러 엔진을 합한 요청 수다.
- 원본의 문서 예측 분포를 보존하는 목표: 이번 GGUF 후보에서는 Q4_K_M(KM)의 손실이 가장 작았다. PPL 6.4873, 같은 엔진 BF16은 6.3694다. 같은 텐서 배정의 Q4_K에 imatrix를 적용한 K1도 K0보다 오차가 줄었다.
- 작은 파일과 이번 실행 조건의 속도: IQ4_XS(I4)는 GGUF 중 가장 작은 3.188 GB였고, 4K 입력 뒤 생성 속도 중앙값은 약 295 tok/s였다. PPL은 6.5649로 KM보다 높다. 이 표본에서 ARC와 IFEval 점수는 GGUF 양자화 후보 중 가장 높았지만, 작은 점수 차이만으로 모든 사용처의 우승 모델이라고 할 수는 없다.
- 같은 INT4 그룹 128에서 방법 비교: GPTQ(G0)는 RTN(R0)·이번 AWQ(A0)보다 문서 NLL/KL을 잘 보존했다. 그러나 KMMLU 점수는 RTN보다 낮았고, 모든 과제의 개선을 보장하지 않았다. AWQ는 여기서 activation-only 20개 배율 탐색 + minmax를 쓴 특정 레시피다.
PPL은 정답 다음 토큰에 부여한 확률의 손실을 지수화한 지표다. PPL이 3% 증가했다고 일반 문제 정확도가 3% 떨어졌다는 뜻은 아니다. 파일 크기, 예측 분포의 보존, 지시 준수, 지식 문제, 실행 속도를 각각 보아야 한다.
원본 엔진 차이도 확인했다. 최종 128문서·130,944개 예측 토큰의 BF16 NLL은 llama.cpp 1.85149764, HF 1.85161384, vLLM 1.85183334다. 작은 차이가 존재하므로 아래의 품질 변화는 항상 같은 엔진 BF16과 비교한다. GGUF 블록 32와 INT4 그룹 128, 혼합 비트, 스케일 저장 정밀도 및 엔진 커널이 모두 같지는 않아 서로 다른 계열 전체를 순수 알고리즘 효과 하나로 해석하지 않는다.
조건과 해석
원본 revision, 교정 128개/검증 32개/최종 128개 문서 및 task 데이터 revision·문항·토큰은 manifest에 고정했다. 최종 평가를 보고 양자화 설정을 다시 선택하지 않았다. 양자화 대상은 공통 텍스트 Linear 200개이며 embedding/head, 작은 GDN a/b 및 비선형 상태·시각 모듈은 고비트로 유지했다.
K0는 Q4_K 무 imatrix, K1은 같은 텐서 배정 + imatrix, KM은 보존 텐서 정책을 유지한 Q4_K_M 혼합 배정, I4는 IQ4_XS다. R0/G0/A0는 대칭 INT4 그룹 128의 RTN/GPTQ/AWQ다. A0는 activation-only 20개 배율 지수 탐색 + minmax이며 별도 clipping 탐색/GPTQ 결합은 없다. 따라서 이름만 같은 외부 체크포인트 전체로 일반화할 수 없다.
native는 실제 packed GGUF 실행, vLLM은 실제 packed INT4 실행이다. hf는 packed 파일을 재로딩하고 BF16으로 복원한 수치 평가이며 그 속도를 INT4 속도로 제시하지 않는다. 각 엔진 BF16 대비 Δ를 우선 해석한다. 수치 평가, 일반 과제, 실행 성능의 우열은 서로 같을 필요가 없다.
최종 문서 NLL/PPL
| 엔진/후보 | PPL | ΔNLL (95% CI) | 평균 KL | 문서 성공/예정 |
|---|---|---|---|---|
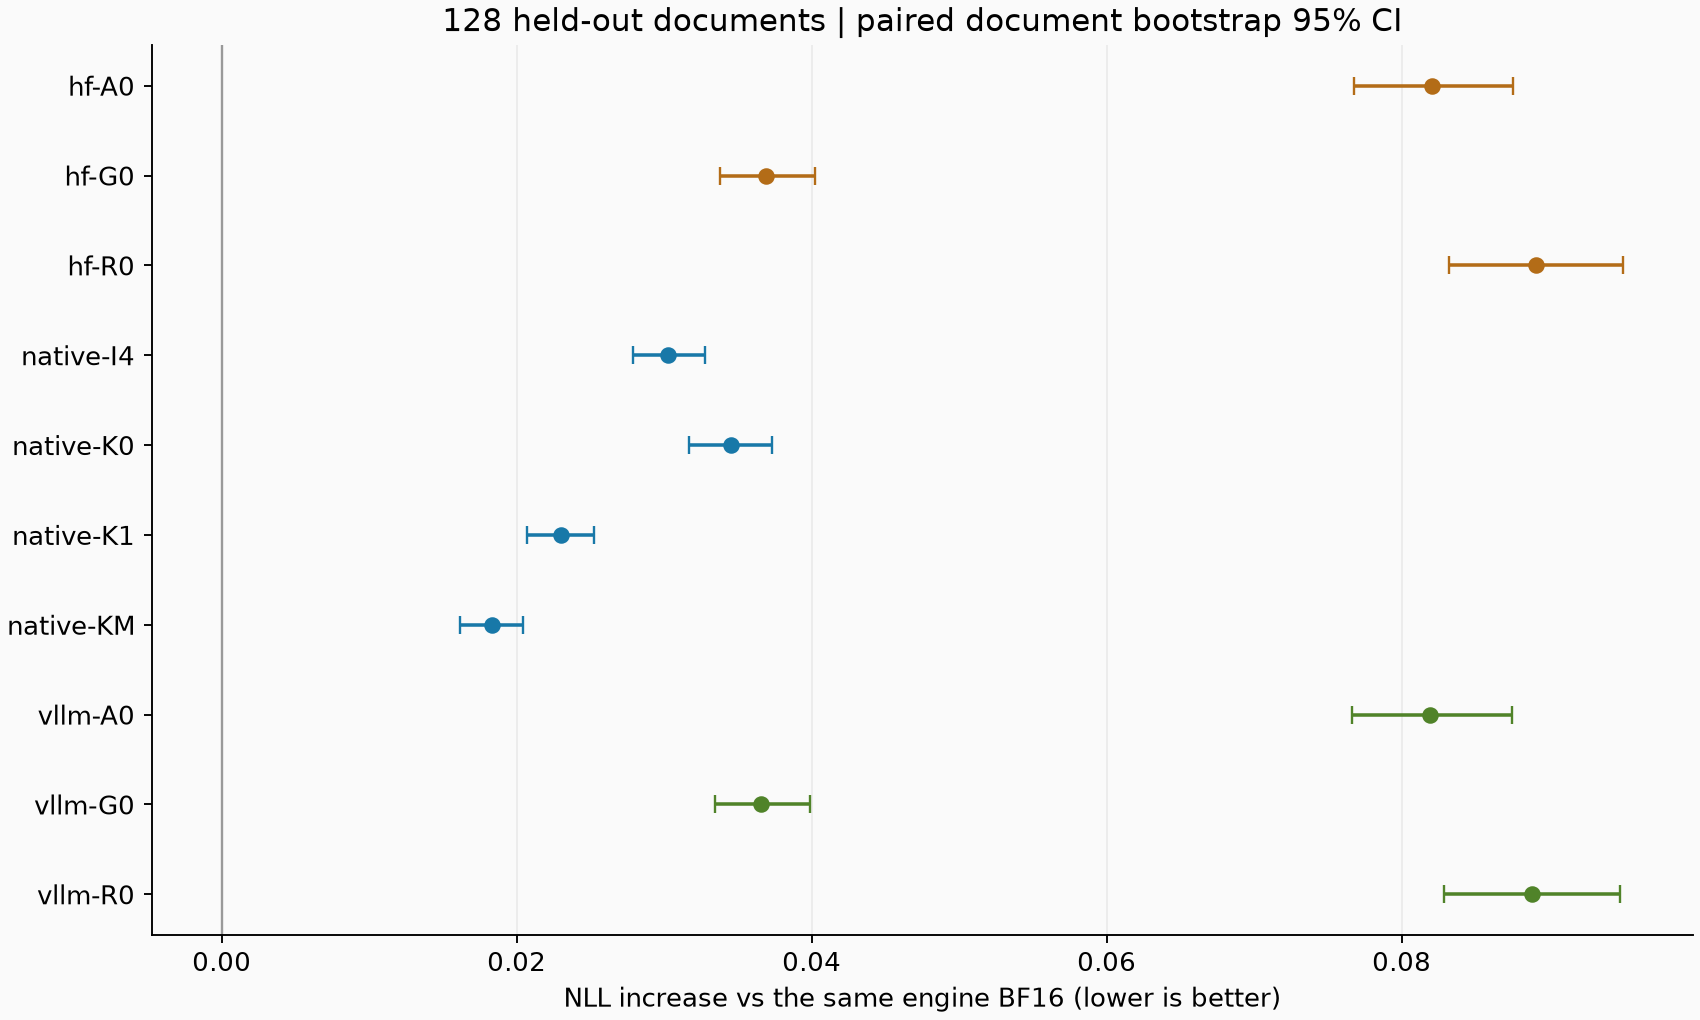
| hf-A0 | 6.9147 | +0.08204 [+0.07676, +0.08755] | 0.097010 | 128/128 |
| hf-B0 | 6.3701 | +0.00000 [+0.00000, +0.00000] | 미실행 | 128/128 |
| hf-G0 | 6.6096 | +0.03691 [+0.03381, +0.04024] | 0.044962 | 128/128 |
| hf-R0 | 6.9639 | +0.08912 [+0.08320, +0.09500] | 0.105990 | 128/128 |
| native-B0 | 6.3694 | +0.00000 [+0.00000, +0.00000] | 미실행 | 128/128 |
| native-I4 | 6.5649 | +0.03024 [+0.02790, +0.03277] | 0.033426 | 128/128 |
| native-K0 | 6.5933 | +0.03455 [+0.03165, +0.03730] | 0.043034 | 128/128 |
| native-K1 | 6.5175 | +0.02299 [+0.02068, +0.02522] | 0.028563 | 128/128 |
| native-KM | 6.4873 | +0.01836 [+0.01615, +0.02042] | 0.024162 | 128/128 |
| vllm-A0 | 6.9155 | +0.08193 [+0.07664, +0.08750] | 미실행 | 128/128 |
| vllm-B0 | 6.3715 | +0.00000 [+0.00000, +0.00000] | 미실행 | 128/128 |
| vllm-G0 | 6.6086 | +0.03654 [+0.03342, +0.03986] | 미실행 | 128/128 |
| vllm-R0 | 6.9633 | +0.08882 [+0.08290, +0.09481] | 미실행 | 128/128 |
KL은 고정된 32개 위치/문서에서 전체 248,320개 어휘를 사용한 BF16→양자화 방향이다. vLLM KL은 측정하지 않았으며 HF 공통 엔진 KL과 혼동하지 않는다. NLL/PPL은 문서 첫 토큰 외 전 토큰에 대해 계산했다. ΔNLL CI는 문서 단위 paired bootstrap 2,000회다. 실패한 문서가 있으면 성공 부분 평균을 전체 모델 지표로 확정하지 않는다.
과제 정확도
| 엔진/후보 | KMMLU 500 | ARC-C 500 (정규화) | IFEval prompt strict | IFEval instruction strict | 실패 문항 |
|---|---|---|---|---|---|
| native-B0 | 0.4820 | 0.5620 | 0.8262 | 0.8777 | 0 |
| native-I4 | 0.4780 | 0.5540 | 0.8189 | 0.8717 | 0 |
| native-K0 | 0.4940 | 0.5300 | 0.8041 | 0.8609 | 0 |
| native-K1 | 0.4660 | 0.5440 | 0.8096 | 0.8657 | 0 |
| native-KM | 0.4880 | 0.5380 | 0.7985 | 0.8585 | 0 |
| vllm-A0 | 0.4380 | 0.5320 | 0.7819 | 0.8465 | 0 |
| vllm-B0 | 0.4880 | 0.5580 | 0.8318 | 0.8837 | 0 |
| vllm-G0 | 0.4320 | 0.5480 | 0.7967 | 0.8573 | 0 |
| vllm-R0 | 0.4720 | 0.5480 | 0.7652 | 0.8309 | 0 |
모든 예정 문항을 분모에 포함하고 실행 실패는 오답으로 기록했다. KMMLU는 과목 균등에 가까운 표본이므로 공식 전체 점수와 다르다. ARC는 raw acc와 문자 길이 정규화 acc를 모두 METRICS에 보관한다. IFEval은 2,048 토큰 상한, greedy, thinking off이다. 항목별 원본 대비 paired CI, 회귀/개선 ID와 응답은 METRICS와 graded JSONL에 남겼다.
크기
| 파일 계열/후보 | 실제 파일 GiB | 공통 텍스트 tensor payload GiB |
|---|---|---|
| native-B0 | 7.846 | 7.836 |
| native-K0 | 3.073 | 3.063 |
| native-K1 | 3.073 | 3.063 |
| native-KM | 3.226 | 3.216 |
| native-I4 | 2.969 | 2.959 |
| hf-B0 | 8.680 | 7.834 |
| hf-R0 | 3.527 | 2.905 |
| hf-G0 | 3.527 | 2.905 |
| hf-A0 | 3.527 | 2.905 |
GGUF는 텍스트 모델, HF 파일에는 vision이 포함될 수 있다. 파일 전체만 비교하여 알고리즘 압축률이라고 단정하지 않는다. tokenizer/설정 파일 포함 전체 폴더 크기는 METRICS에 있다.
실제 실행 속도
| 엔진/후보 | 입력 | TTFT ms 중앙값 | prefill tok/s | decode tok/s | 장치 전체 VRAM peak GiB |
|---|---|---|---|---|---|
| native-B0 | 512 | 38.24 | 13399.9 | 155.9 | 11.82 |
| native-B0 | 4096 | 303.69 | 13488.6 | 155.7 | 11.82 |
| native-I4 | 512 | 32.15 | 15933.9 | 293.9 | 6.94 |
| native-I4 | 4096 | 254.34 | 16105.9 | 295.3 | 6.94 |
| native-K0 | 512 | 32.98 | 15536.0 | 285.6 | 7.09 |
| native-K0 | 4096 | 262.21 | 15622.5 | 279.3 | 7.09 |
| native-K1 | 512 | 33.07 | 15493.5 | 287.3 | 7.00 |
| native-K1 | 4096 | 262.94 | 15579.3 | 280.1 | 7.00 |
| native-KM | 512 | 33.91 | 15106.5 | 273.4 | 7.20 |
| native-KM | 4096 | 270.57 | 15139.5 | 275.8 | 7.20 |
| vllm-A0 | 512 | 45.51 | 11529.7 | 50.1 | 28.43 |
| vllm-A0 | 4096 | 211.08 | 19549.4 | 45.0 | 29.06 |
| vllm-B0 | 512 | 44.44 | 11892.2 | 57.8 | 28.37 |
| vllm-B0 | 4096 | 201.70 | 20444.3 | 56.3 | 28.95 |
| vllm-G0 | 512 | 49.59 | 10631.9 | 45.1 | 28.34 |
| vllm-G0 | 4096 | 217.79 | 18946.8 | 50.2 | 28.95 |
| vllm-R0 | 512 | 47.97 | 10955.4 | 50.7 | 28.42 |
| vllm-R0 | 4096 | 192.34 | 21451.0 | 45.4 | 29.06 |
batch 1, 생성 256 토큰, warmup 2회 + 측정 5회이며 min/max도 METRICS에 있다. native는 BF16 KV와 512 microbatch, vLLM은 eager와 prefix-cache off를 사용한다. VRAM은 100ms NVML 관측의 장치 전체 사용량이며 다른 앱과 엔진 예약 cache를 포함한다. 이를 순수 가중치 메모리나 요청의 process peak로 해석하지 않는다. vLLM의 80% memory budget은 모델마다 같은 설정이고 최적화된 최소 메모리 크기가 아니다.
꼬리 오차·실패·한계
- hf-A0: 문서 ΔNLL median=+0.08202, p95=+0.13523, p99=+0.17446, max=+0.18555. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
- hf-B0: 문서 ΔNLL median=+0.00000, p95=+0.00000, p99=+0.00000, max=+0.00000. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
- hf-G0: 문서 ΔNLL median=+0.03632, p95=+0.06312, p99=+0.10133, max=+0.13964. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
- hf-R0: 문서 ΔNLL median=+0.08880, p95=+0.14888, p99=+0.16016, max=+0.19973. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
- native-B0: 문서 ΔNLL median=+0.00000, p95=+0.00000, p99=+0.00000, max=+0.00000. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
- native-I4: 문서 ΔNLL median=+0.02779, p95=+0.05721, p99=+0.07026, max=+0.07380. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
- native-K0: 문서 ΔNLL median=+0.03247, p95=+0.06357, p99=+0.07378, max=+0.08018. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
- native-K1: 문서 ΔNLL median=+0.02253, p95=+0.04751, p99=+0.05471, max=+0.06654. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
- native-KM: 문서 ΔNLL median=+0.01692, p95=+0.03945, p99=+0.04871, max=+0.06109. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
- vllm-A0: 문서 ΔNLL median=+0.08128, p95=+0.13445, p99=+0.17383, max=+0.18086. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
- vllm-B0: 문서 ΔNLL median=+0.00000, p95=+0.00000, p99=+0.00000, max=+0.00000. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
- vllm-G0: 문서 ΔNLL median=+0.03581, p95=+0.06273, p99=+0.09966, max=+0.13673. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
- vllm-R0: 문서 ΔNLL median=+0.08799, p95=+0.14856, p99=+0.15872, max=+0.19832. 최악 20문서 ID와 token 꼬리는 METRICS에 저장.
내부 블록 진단
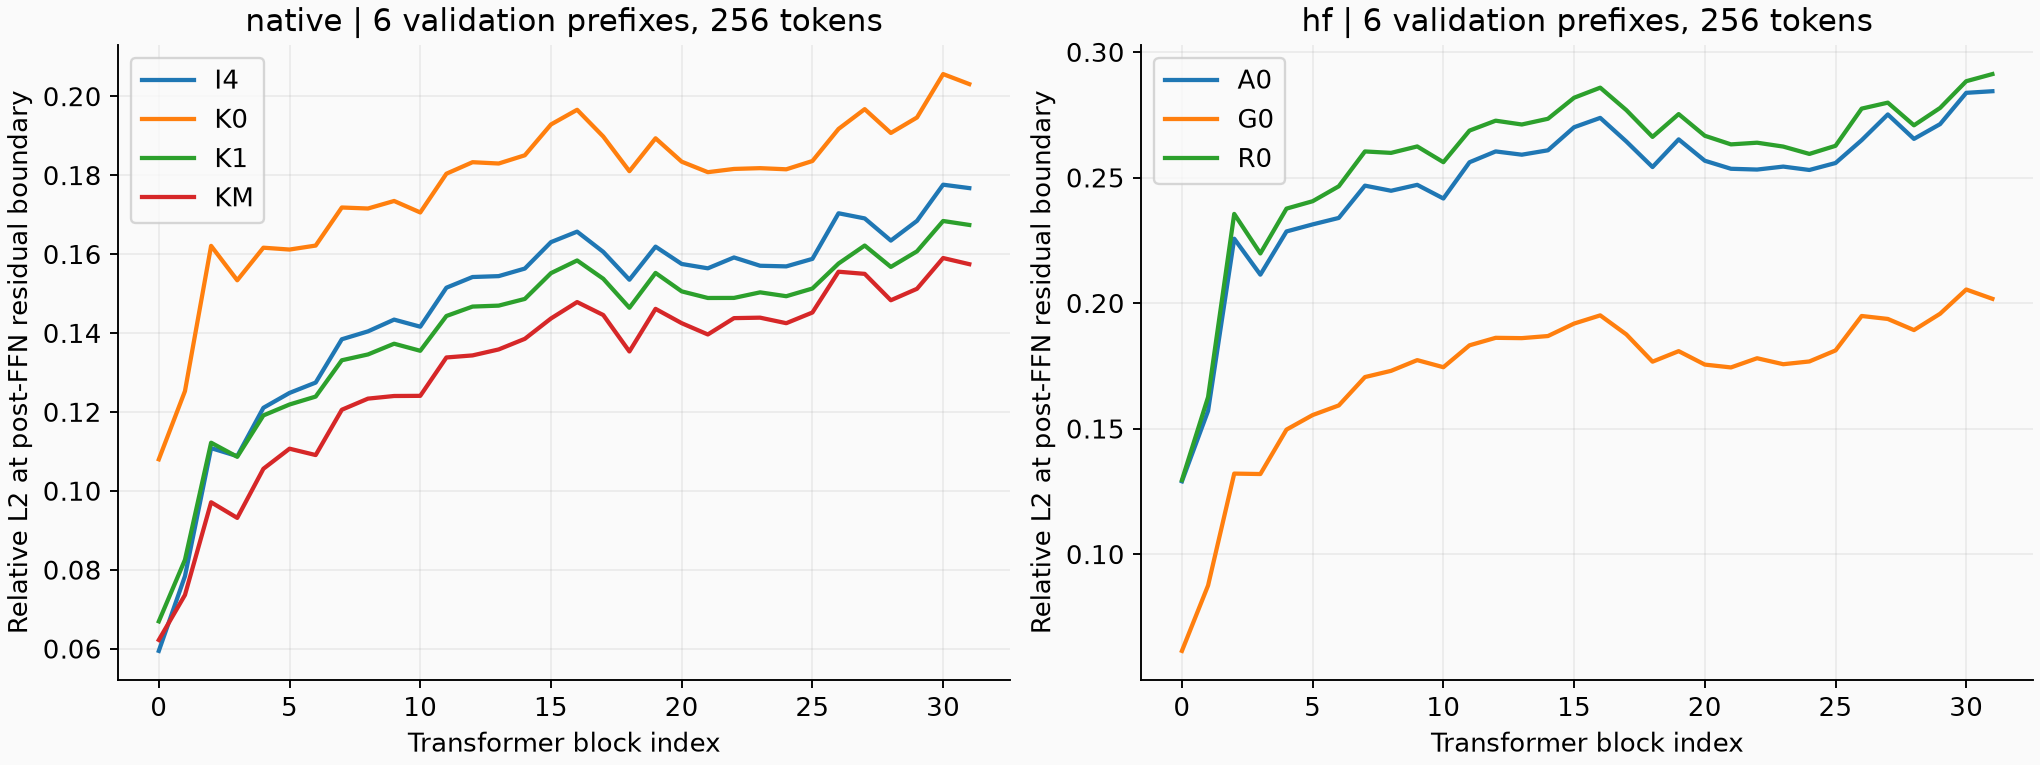
각 영역의 검증 문서 2개씩 총 6개, 첫 256토큰, 32개 블록의 FFN 이후 residual 경계에서 원본 대비 상대 L2를 계산했다. 이는 앞 블록 오차가 누적된 전체 실행의 차이다. AWQ의 배율이 상쇄되는 공통 residual 좌표에서 비교하며, 개별 행렬에 같은 입력을 재생하는 국소 영향과 구분한다. block-errors.jsonl에 token별 분포, 절대 RMSE와 near-zero 기준 비율을 저장했다. vLLM 내부 블록 hook은 별도 미측정이다.
한국어/영어 Wikipedia 및 CPython 표준 라이브러리는 실사용 전체를 대표하지 않는다. 문서 SHA 중복은 제거했으나 의미상 중복과 사전학습 오염 부재를 보장하지 않는다. bootstrap CI는 고정된 양자화 1회와 표본의 불확실성이며 모든 교정 seed나 재양자화 변동을 포함하지 않는다. 여러 후보의 CI는 다중 비교 보정을 하지 않은 탐색적 구간이다. AWQ 원래 좌표로의 전체 가중치 MSE, 국소 행렬 입력 재생 및 실제 사용자 대화 평가는 별도 미측정 항목이다. 제작 시 CPU peak RAM은 기록되지 않았으며 GPU peak와 제작 시간은 후보 quantization-complete와 로그에 보존한다. 모델 내부 손실을 평균 NLL 하나로 모두 설명할 수 없으므로 영역별·꼬리·문항 회귀를 함께 본다.
native 시간은 프로세스 안의 decode 호출과 CPU argmax를 포함하고 JSON 전달/모델 로드는 제외한다. vLLM TTFT는 엔진 arrival~first token이고 스케줄러를 포함한다. HTTP 서버 end-to-end TTFT나 동일 저수준 연산만의 속도로 해석하지 않는다.
결과를 어떻게 해석할까
같은 Q4_K 텐서 배정에서 imatrix 효과를 분리하면 K1−K0의 ΔNLL은 −0.01156, paired 95% CI는 [−0.01341, −0.00960]이다. tensor payload는 같고 파일 차이 320바이트는 메타데이터에서 생긴다. 중요도 정보를 사용한 근사가 문서 예측에는 도움이 됐다는 직접적인 결과다. 반면 과제별 K1−K0 점수 CI는 세 과제 모두 0을 포함하여 그 개선을 같은 강도로 주장할 수 없다.
KM은 K1보다 약 0.165 GB 커졌고 ΔNLL은 −0.00464 [−0.00544, −0.00380] 줄었다. 고비트 텐서 배정은 문서 분포 보존에 도움이 됐지만, IFEval은 79.85%로 K1의 80.96%보다 낮았다. 예측 오차가 줄어드는 것과 생성한 답변이 개별 형식 조건을 통과하는 것은 서로 다른 측정이다.
vLLM에서 GPTQ−RTN의 ΔNLL은 −0.05229 [−0.05692, −0.04765]다. IFEval도 GPTQ가 3.14 percentage points 높았지만, KMMLU는 GPTQ 43.2%, RTN 47.2%로 순서가 바뀌었다. 이 KMMLU 두 후보 차이의 paired CI는 [−8.4, +0.2] percentage points로 0을 포함한다. GPTQ가 모든 지식 문제에서 더 나쁘다고 확정할 근거도 부족하다.
이번 AWQ는 RTN보다 NLL이 −0.00689 [−0.00974, −0.00380] 줄었으나 GPTQ보다 개선 폭이 작았다. 영어 문서에서는 오히려 RTN보다 NLL이 조금 높았다. 이는 그룹 크기나 AWQ 탐색/클리핑을 바꿔 다시 시험해 볼 근거가 될 수 있지만, 이번 최종 세트로 최적값을 고르는 재튜닝은 하지 않았다. 새 레시피를 시험한다면 validation에서 고르고 새 최종 세트를 마련해야 한다.
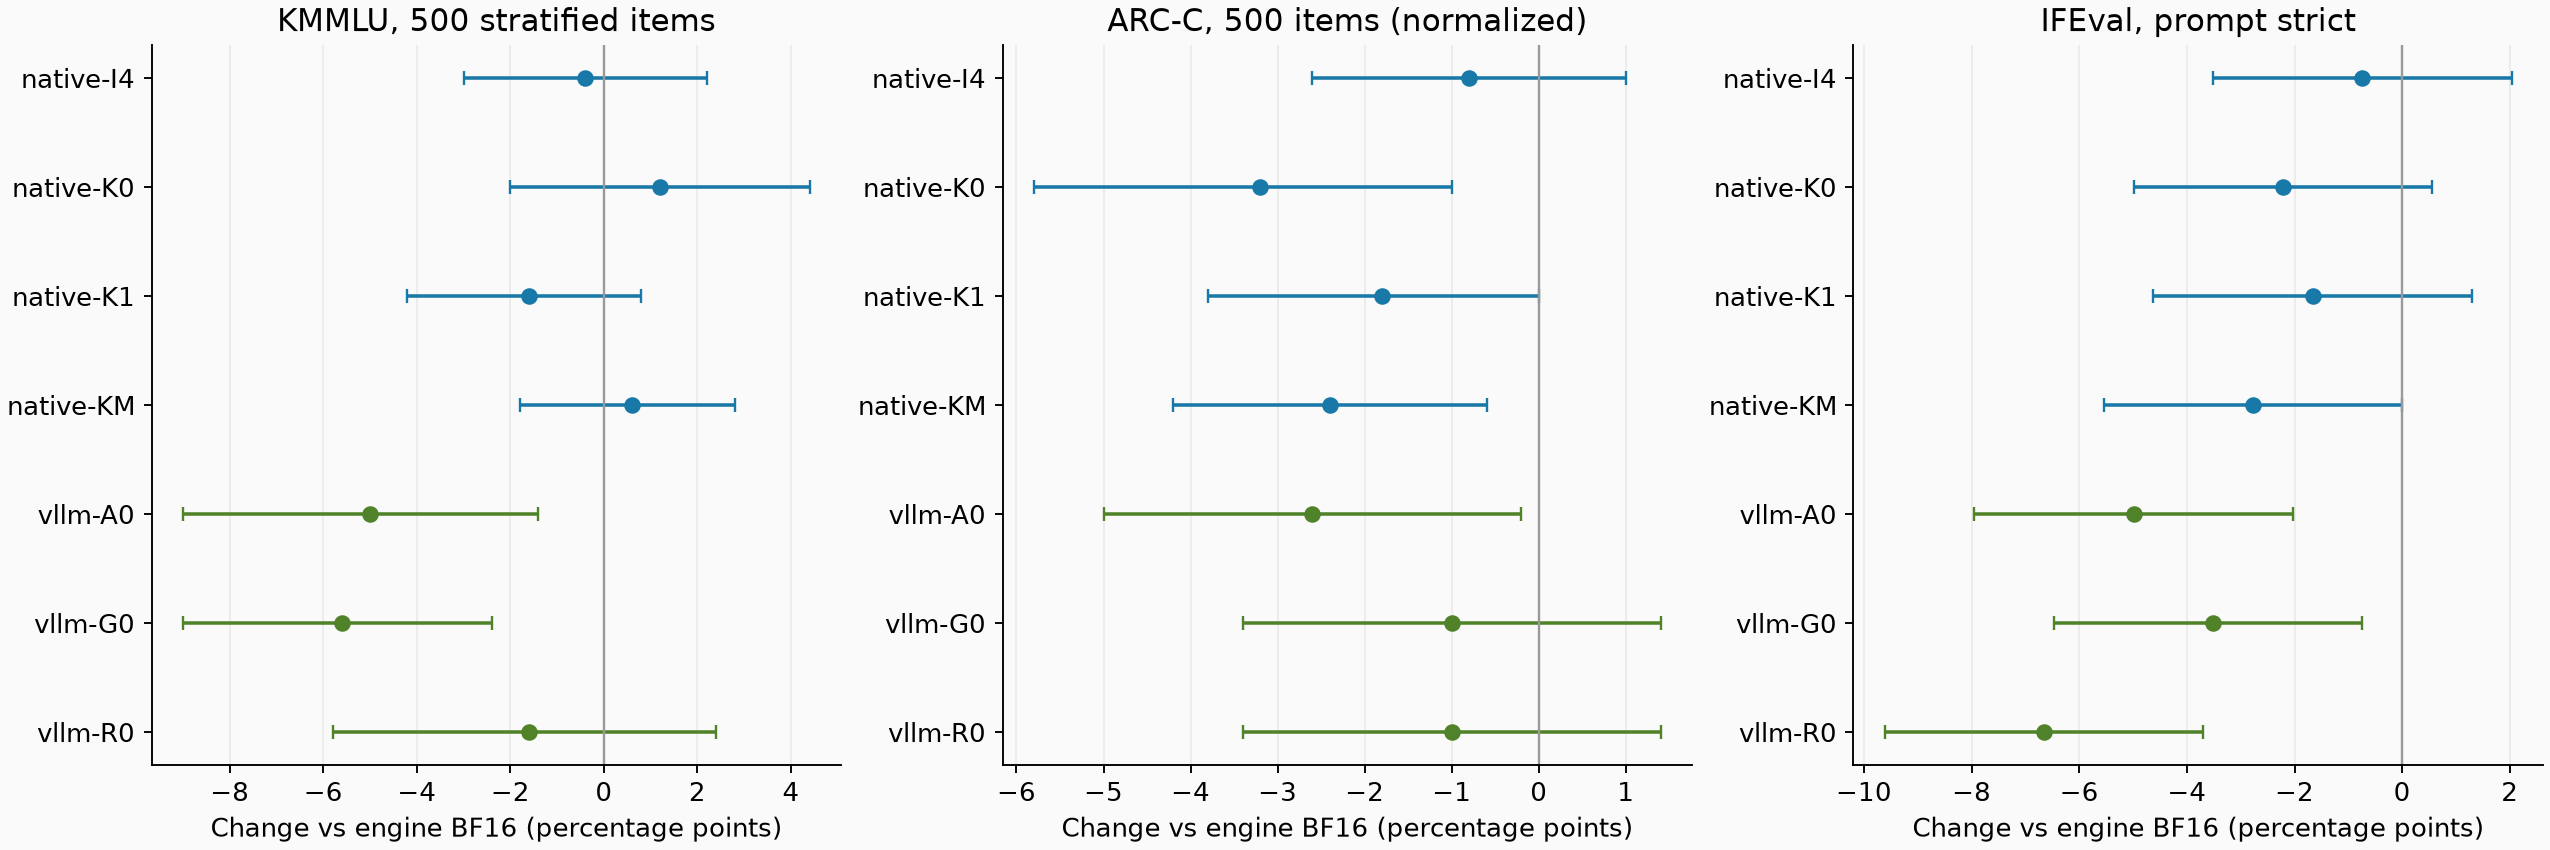
아래 CI는 문항/문서 단위 paired bootstrap 2,000회이고 여러 후보에 대한 다중 비교 보정을 하지 않았다. 점수 차이가 작거나 구간에 0이 들어가면 순위를 확정하지 않는다. 고정된 양자화 1회에 대한 결과여서 다른 calibration seed에서의 변동을 모두 포함하지 않는다.
같은 엔진 BF16 대비 과제 점수 변화
단위는 percentage points다. 대괄호는 paired 95% CI이며 ARC는 문자 길이 정규화 점수다.
| 후보 | KMMLU | ARC-C | IFEval prompt strict |
|---|---|---|---|
| native-I4 | -0.40 [-3.00, +2.20] | -0.80 [-2.60, +1.00] | -0.74 [-3.51, +2.03] |
| native-K0 | +1.20 [-2.00, +4.40] | -3.20 [-5.80, -1.00] | -2.22 [-4.99, +0.55] |
| native-K1 | -1.60 [-4.20, +0.80] | -1.80 [-3.80, +0.00] | -1.66 [-4.62, +1.29] |
| native-KM | +0.60 [-1.80, +2.80] | -2.40 [-4.20, -0.60] | -2.77 [-5.55, +0.00] |
| vllm-A0 | -5.00 [-9.00, -1.40] | -2.60 [-5.00, -0.20] | -4.99 [-7.95, -2.03] |
| vllm-G0 | -5.60 [-9.00, -2.40] | -1.00 [-3.40, +1.40] | -3.51 [-6.47, -0.74] |
| vllm-R0 | -1.60 [-5.80, +2.40] | -1.00 [-3.40, +1.40] | -6.65 [-9.61, -3.70] |
영역별 예측 오차
각 영역의 같은 엔진 BF16 대비 ΔNLL이다. 한국어 64문서, 영어 32문서, 코드 32문서이며 모든 문서는 1,024토큰 prefix다. 코드 결과는 CPython 표준 라이브러리에 한정되고 코드 생성 능력 점수가 아니다.
| 후보 | 한국어 | 영어 | 코드 |
|---|---|---|---|
| native-K0 | +0.04032 | +0.02407 | +0.03351 |
| native-K1 | +0.02686 | +0.01660 | +0.02166 |
| native-KM | +0.02229 | +0.01040 | +0.01844 |
| native-I4 | +0.03174 | +0.02754 | +0.02996 |
| vllm-R0 | +0.10466 | +0.06356 | +0.08240 |
| vllm-G0 | +0.03839 | +0.03716 | +0.03221 |
| vllm-A0 | +0.09347 | +0.06877 | +0.07203 |
평균 외 꼬리도 비교했다. native-K0의 문서 ΔNLL p95/max는 0.06357/0.08018, K1은 0.04751/0.06654, KM은 0.03945/0.06109였다. vLLM-GPTQ의 p95/max는 0.06273/0.13673이고 AWQ는 0.13445/0.18086이었다. 최악 문서 ID와 토큰별 꼬리는 METRICS.json에 남겼다. 이런 꼬리 차이도 특정 실제 대화의 실패를 곧바로 예측하는 보장은 아니다.
6개 검증 prefix에서 마지막 블록의 누적 상대 L2는 native K0 0.2031, K1 0.1674, KM 0.1575, I4 0.1767이며, HF GPTQ 0.2017, AWQ 0.2844, RTN 0.2912다. 이 값은 앞 블록들의 오차가 누적된 residual 차이이고 특정 가중치 행렬 하나의 재구성 오차가 아니다. 정확한 각 층 수치는 block-errors.jsonl에 있다.
실제 회귀와 개선 사례
후보별 IFEval 회귀/개선에서 ID 사전순 첫 사례를 저장했고, 아래 세 사례의 원문·응답과 판정 조건을 직접 확인했다. 전체를 대표하도록 고른 통계 표본이 아니라 실패 양상을 보여 주는 예시다. 전체 응답은 FAILURE-CASES.json과 results/graded-*.jsonl에 있다.
- JSON 형식 누락 — ifeval-1075, IQ4_XS. 기저귀 광고 전체를 JSON으로 달라는 요청이다. BF16은 정상 JSON을 반환했고 I4는 내부 객체를 닫은 뒤 바깥 객체의 마지막
}를 빠뜨렸다. 출력 길이 제한에 걸리지 않은 응답인데도 strict 형식 검사에서 실패했다. 문장의 자연스러움만 보면 놓치기 쉬운 변화다. - 단어 횟수 조건 — ifeval-1203, Q4_K 무 imatrix.
war8회 이상,peace10회 이상이라는 조건에서 BF16은 각각 10/11회, K0는 10/9회였다. 내용이 길고 그럴듯해도 단어 하나가 부족해서 실패했다. 이 검사는 당나라 역사 서술의 사실성까지 판정한 것은 아니다. - 양자화 후 통과한 예 — ifeval-1092, GPTQ. 일본 여행 글을 300단어 미만으로 쓰라는 요청에서 vLLM BF16은 grader의
\w+단어 계산으로 307개, GPTQ는 247개였다. BF16이 실패하고 양자화 모델이 통과한 경우도 있다. 이는 양자화가 일반적인 글쓰기 능력을 높였다는 증거가 아니라 특정 생성 경로가 조건을 만족한 사례다.
최대 2,048토큰에서 잘린 IFEval 출력도 버리지 않았다. native B0/K0/K1/KM/I4는 13/18/17/21/13개, vLLM B0/RTN/GPTQ/AWQ는 14/45/19/49개다. 모두 541개 분모에 포함해 실제 반환된 출력으로 채점했다. 잘렸다고 자동으로 전부 오답 처리한 것은 아니며 명세의 각 조건을 검사했다.
용량과 속도를 함께 볼 때
공통 텍스트 payload의 실제 평균 bit/weight는 K0·K1 6.255, KM 6.569, I4 6.043, HF INT4 3종 5.934다. 전체 텍스트 모델이 균일 4비트인 것이 아니다. 임베딩/공유 head 등 보존 가중치와 그룹 스케일/메타데이터 때문에 높아진다. 큰 임베딩을 고정밀로 유지한 이번 학습용 정책은 일반 배포용 기본 Q4_K_M 정책과 구분해야 한다.
4K 입력의 native BF16 decode는 중앙값 155.7 tok/s이고 K1은 280.1, KM은 275.8, I4는 295.3 tok/s였다. 파일 감소가 이 실행에서는 decode 향상으로 이어졌다. 그러나 vLLM eager에서는 BF16 56.3 tok/s, INT4 후보 45.0~50.2 tok/s로 양자화가 더 빠르지 않았다. 실제 Marlin 커널을 썼지만, 작은 batch와 eager 실행, GDN 처리와 스케줄러 등 전체 경로의 비용을 따로 분해하지 않았으므로 느린 원인 하나를 확정하지 않는다. vLLM 일반 성능이나 CUDA graph를 켠 최적화 구성의 성능으로 확대 해석하지 않는다.
5회 반복 범위도 함께 제시한다. vLLM 반복 간 변동은 native보다 커서 1~2 tok/s 수준의 작은 순위 차이를 강조하지 않는다. 최소/최대는 관측 범위이며 모집단 신뢰구간은 아니다. HTTP 요청 전체 지연, 다중 사용자 처리량, 장시간 평균 속도는 별도 미측정이다.
| 4K 입력 후보 | TTFT ms 중앙값 [최소, 최대] | decode tok/s 중앙값 [최소, 최대] |
|---|---|---|
| native-B0 | 303.7 [301.5, 311.1] | 155.7 [153.6, 162.5] |
| native-I4 | 254.3 [252.3, 300.5] | 295.3 [270.0, 296.4] |
| native-K0 | 262.2 [260.7, 265.7] | 279.3 [259.8, 285.5] |
| native-K1 | 262.9 [262.5, 278.3] | 280.1 [261.7, 285.8] |
| native-KM | 270.6 [269.2, 335.8] | 275.8 [253.6, 278.3] |
| vllm-A0 | 211.1 [209.3, 245.8] | 45.0 [41.6, 54.6] |
| vllm-B0 | 201.7 [191.1, 213.9] | 56.3 [45.2, 58.7] |
| vllm-G0 | 217.8 [213.9, 219.5] | 50.2 [36.2, 58.5] |
| vllm-R0 | 192.3 [192.1, 245.3] | 45.4 [35.8, 54.3] |
vLLM 시작 로그의 가중치 점유는 BF16 약 7.99 GiB, INT4 약 3.11 GiB였다. 표의 약 28~29 GiB는 엔진이 예약한 큰 cache와 다른 앱을 포함하는 GPU 전체 관측치다. 양자화 가중치 자체가 29 GiB라는 뜻이 아니다. native도 모델 버퍼, KV 256 MiB, recurrent state 50.25 MiB, compute 버퍼와 장치 전체 관측치를 구분해 METRICS에 기록했다. 메모리 최소화 설정은 탐색하지 않았다.
검토에서 수정한 측정 누락과 완료 범위
최종 검토에서 vLLM 시간 통계가 비활성화되어 TTFT/prefill/decode 필드가 없던 것을 발견했다. 성능 단계에서만 통계를 켜고 vLLM 0.26의 first_token_latency 및 monotonic 타임스탬프를 사용하도록 수정했다. 이전 기록과 소스를 보존하고 vLLM 4개 후보를 모두 같은 규칙으로 재측정했다. 전후 56개 benchmark 응답의 생성 토큰열은 모두 정확히 같았다. 모델과 품질 결과를 재튜닝하거나 다시 고르지 않았다. 새 측정에는 통계 수집 비용도 포함된다. PROTOCOL-CHANGES.md 항목 21을 참조한다.
최종 완료 범위는 고정된 텍스트 모델 8후보, 실제 packed 실행 검증, 같은 prefix 수치 평가, 고정 과제, 내부 residual 진단, 파일 크기, 반복 실행 속도와 GPU 장치 메모리, 통계와 사례 분석이다. HF KL은 저장된 packed 가중치를 BF16으로 복원한 실행에서 계산했고 vLLM 전체 어휘 KL은 별도 미측정이다. full fine-tuning/포스트 트레이닝, vision/MTP, 긴 문맥 품질, 실제 사용자 채팅, 다른 calibration seed 반복, 모든 양자화 레시피의 최적 탐색은 이번 완료 범위에 포함되지 않는다.
검토 근거: results/final-review-audit.json. 13개 평가의 요청 ID/순서/분모, 기술적 실패 0, 채점 예외 0, 9개 전용 benchmark의 시간·256토큰·2회 warmup/5회 측정, 고정 데이터 hash와 복구 후 50개 파일 검증을 확인했다. 비교 그림 3개에서 축/레이블/범례와 수치를 직접 검토했다. 별도 독립 검토자의 재현 실행까지 완료했다는 뜻은 아니다.
근거 파일
- RUNBOOK.md, PROTOCOL-CHANGES.md: 실행 조건과 변경 이유
- data/*manifest.json: 원본 데이터 revision, 고정 파일 SHA
- results/evaluation-*.jsonl: 요청별 원시 측정과 실패
- results/graded-*.jsonl: 문항별 채점, 생성 응답
- results/reload.json, preflight-.json: 재로딩 및 상태 초기화 검증
- block-errors.jsonl: 공통 residual 경계의 누적 오차
- logs/: 변환·양자화·실행의 전체 로그
- METRICS.json: 영역별 지표, bootstrap CI, 꼬리, 실패 ID, 반복 속도 범위
재부팅과 복구 기록
2026-09-22 10:24 KST에 Windows가 0xD1 블루스크린 후 재시작했다. Windows는 NETIO.SYS를 관련 드라이버로 기록했지만 상세 덤프 접근 권한이 없어 근본 원인은 확정하지 못했다. 당시 vLLM-A0 평가 중이었다는 사실만으로 vLLM이나 GPU를 원인으로 단정하지 않는다. 사용자의 재개 요청 후 원본·양자화 모델·동결 데이터 체크섬을 이전 manifest와 대조하고, 기존 validation 2문서의 AWQ NLL 및 상태 초기화 재현성을 확인했다.
진행 상태 파일의 NULL 바이트 손상은 원본 바이트를 보존한 뒤 요청별 결과에서 복구했다. 저장된 AWQ 4,582개 요청을 유지하고 미저장 132개만 이어갔다. 완료된 최종 출력을 유리한 방향으로 재선택하지 않았다. 이후 상태/결과 기록에 fsync를 추가했다. 전용 속도 측정은 모든 9개 구성에 대해 재부팅 후 동일한 warmup 2회/측정 5회 규칙으로 진행했으며, 이전 측정은 보조 기록으로 보존한다. 재부팅 전후의 운영 환경 차이와 근본 원인 미확정은 본 실험의 운영상 한계다.
근거: results/crash-20260922/INCIDENT.md, system-events.json, artifact-revalidation.json, awq-validation-replay.json 및 PROTOCOL-CHANGES.md 항목 20.
비교 그림